
News · Google · 31. Oktober 2026
KI-Training per robots.txt sperren: Google und Bing unterstützen 1 gemeinsames Signal
Von Engin Buldak · Geschäftsführer DTILE GmbH · veröffentlicht am 31. Oktober 2026
Bisher musste jeder Website-Betreiber jedem KI-Anbieter einzeln sagen, ob er seine Inhalte zum Training nutzen darf. Damit soll Schluss sein: Google und Microsoft haben am 30. Oktober 2026 angekündigt, 1 gemeinsames Signal in der robots.txt zu unterstützen, entwickelt in einer Arbeitsgruppe der Internet Engineering Task Force (IETF), dem Gremium für technische Internet-Standards. Microsoft nennt dazu feste Termine und baut zusätzlich eine eigene Einstellung für KI-Antworten. Alle Angaben stammen aus dem Google Search Central Blog, der Google-Crawler-Dokumentation und dem Microsoft Bing Blog.
Was Google und Microsoft am 30. Oktober angekündigt haben
Google und Microsoft wollen ein gemeinsames Signal in der robots.txt unterstützen, mit dem eine Website der Nutzung ihrer Inhalte für KI-Training widerspricht. Google schreibt im Search Central Blog, Website-Betreiber könnten ihre Wünsche zum KI-Training damit "über mehrere KI-Anbieter hinweg in 1 Schritt" ausdrücken. Die robots.txt ist die Textdatei im Hauptverzeichnis einer Website, die Suchmaschinen und anderen Crawlern Regeln vorgibt.
- Angekündigt
- 30. Oktober 2026 im Google Search Central Blog (John Mueller) und im Microsoft Bing Blog (Krishna Madhavan)
- Grundlage
- Entwurf der Arbeitsgruppe AI Preferences (AIPREF) der IETF
- Schreibweise
- User-Agent: __usage_ai-training, darunter Disallow für gesperrte Bereiche
- Regelt
- Nur die Nutzung von Inhalten zum Training von KI-Modellen
- Will das Signal laut Crawler-Dokumentation Anfang 2027 unterstützen
- Microsoft Bing
- Wertet die neuen Angaben ab 1. Februar 2027 beim Crawlen aus
- Standard
- Ohne Eintrag ist Training erlaubt
Laut Google steht die Regel im Einklang mit dem EU-Verhaltenskodex für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck unter dem EU AI Act, der die robots.txt als zentralen maschinenlesbaren Weg für solche Wünsche anerkennt. Wie die robots.txt grundsätzlich funktioniert, erklärt der Lexikoneintrag robots.txt.
So sieht die Regel in der robots.txt aus
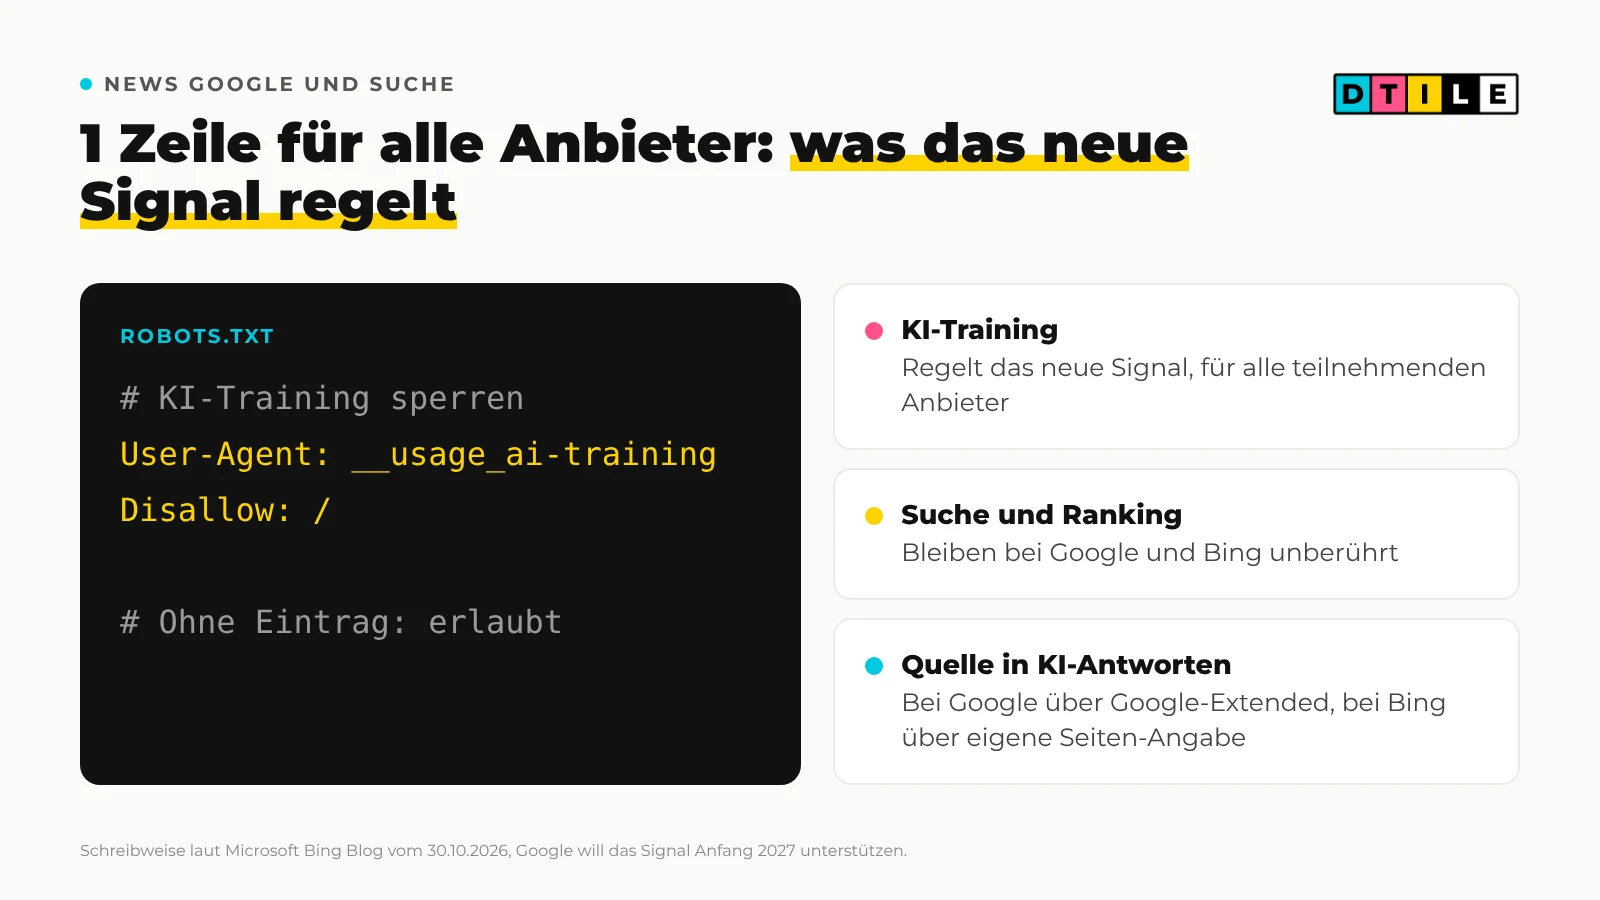
Die Regel nutzt einen gemeinsamen Namen, ein sogenanntes Policy Token (Richtlinien-Kennung), statt eines echten Crawlers. Wer KI-Training für die ganze Website ausschließen will, trägt laut Microsoft Bing Blog 2 Zeilen ein. Ohne Eintrag gilt Training als erlaubt.
- 1
Ganze Website sperren
User-Agent: __usage_ai-training und darunter Disallow: / in die robots.txt schreiben.
- 2
Nur einen Bereich sperren
Statt / den Pfad angeben, zum Beispiel Disallow: /ratgeber/. Der Rest der Website bleibt für Training freigegeben.
- 3
Bestimmte Anbieter anders behandeln
Die bisherigen Kennungen der Anbieter gelten weiter. Bei Google ist das Google-Extended. Wer dort ausdrücklich etwas festlegt, steuert Google getrennt vom gemeinsamen Signal.
- 4
Bei Bing einzelne Seiten steuern
Microsoft erweitert die Angabe auf Seitenebene, per Meta-Tag oder HTTP-Header, zum Beispiel ai-training:disallow für den Bingbot. Die Seitenangabe überschreibt die robots.txt.
Wichtig für Google: Nutzt eine Website das gemeinsame Signal und nennt Google-Extended nicht ausdrücklich, behandelt Google das laut Search Central Blog so, als hätte sie Google-Extended gesperrt. Was ein Crawler ist und welche es gibt, steht im Lexikoneintrag Crawler.
Was die Sperre für deine Sichtbarkeit bedeutet
Auf die klassische Suche hat das Signal keinen Einfluss. Google-Extended wirkt laut Google-Crawler-Dokumentation weder auf die Aufnahme in die Google-Suche noch auf das Ranking, und Microsoft schreibt, die klassischen Bing-Rankings blieben unberührt. Bei KI-Antworten sieht es anders aus.
| Bereich | Microsoft Bing | |
|---|---|---|
| KI-Training | Gemeinsames Signal wird wie eine Sperre von Google-Extended behandelt | Gemeinsames Signal in der robots.txt, zusätzlich je Seite |
| Klassische Suche und Ranking | Nicht betroffen | Nicht betroffen |
| Quelle für KI-Antworten | Google-Extended regelt auch die Nutzung in den Gemini-Apps | Eigene Angabe AI Grounding je Seite: Allow, DisallowExtended oder Disallow |
| KI-Übersichten und KI-Modus | Eigene Einstellung in der Search Console | Über die Angabe AI Grounding je Seite |
KI-Training
- Gemeinsames Signal wird wie eine Sperre von Google-Extended behandelt
- Microsoft Bing
- Gemeinsames Signal in der robots.txt, zusätzlich je Seite
Klassische Suche und Ranking
- Nicht betroffen
- Microsoft Bing
- Nicht betroffen
Quelle für KI-Antworten
- Google-Extended regelt auch die Nutzung in den Gemini-Apps
- Microsoft Bing
- Eigene Angabe AI Grounding je Seite: Allow, DisallowExtended oder Disallow
KI-Übersichten und KI-Modus
- Eigene Einstellung in der Search Console
- Microsoft Bing
- Über die Angabe AI Grounding je Seite
Was das Signal berührt, laut Google und Microsoft, Stand 31. Oktober 2026
Der entscheidende Punkt steht im Google-Blog: Websites, die Google-Extended ausdrücklich erlauben, können in Antworten der Gemini-Apps erscheinen und über diese Quellenangaben Klicks bekommen. Google-Extended regelt laut Dokumentation neben dem Training auch diese Nutzung. Wer pauschal sperrt, riskiert also, als Quelle in Gemini zu fehlen. Für die KI-Übersichten und den KI-Modus der Google-Suche gibt es eine eigene Einstellung, die wir in der News KI-Antworten ausschließen erklären.
Kostenlose Potenzialanalyse
Wie viele Kunden findest du
noch über Google und KI?
In 15 Minuten siehst du, wo du heute stehst und wie viele Anfragen und Umsatz realistisch drin sind.
Microsoft trennt Training und KI-Antworten
Microsoft geht einen Schritt weiter und trennt 2 Dinge: das Training von Modellen und die Nutzung von Inhalten als Quelle für KI-Antworten, bei Microsoft Grounding (Verankerung) genannt. Beides lässt sich unabhängig einstellen, und beides ist ohne Angabe erlaubt.
- AI Training: das gemeinsame Signal in der robots.txt, bei Bing zusätzlich je Seite per Meta-Tag oder HTTP-Header
- AI Grounding Allow: Inhalte dürfen KI-Antworten speisen, das ist der Standard
- AI Grounding DisallowExtended: nur in Diensten, die Microsoft selbst betreibt, etwa Copilot und Microsoft 365, nicht in Diensten für Dritte
- AI Grounding Disallow: keine Nutzung als Quelle für KI-Antworten
- Die neuen Angaben ersetzen die bisherigen Kennzeichnungen NoArchive und NoCache
Microsoft warnt selbst: Wer DisallowExtended oder Disallow wählt, verliert deutlich an Sichtbarkeit in KI-Antworten. Weder die eine noch die andere Wahl garantiere Aufnahme, Besucher oder Bezahlung. Wie du dein Unternehmen bei Bing sichtbar machst, zeigt der Ratgeber Bing Places.
Die Fristen bis 2027 im Überblick
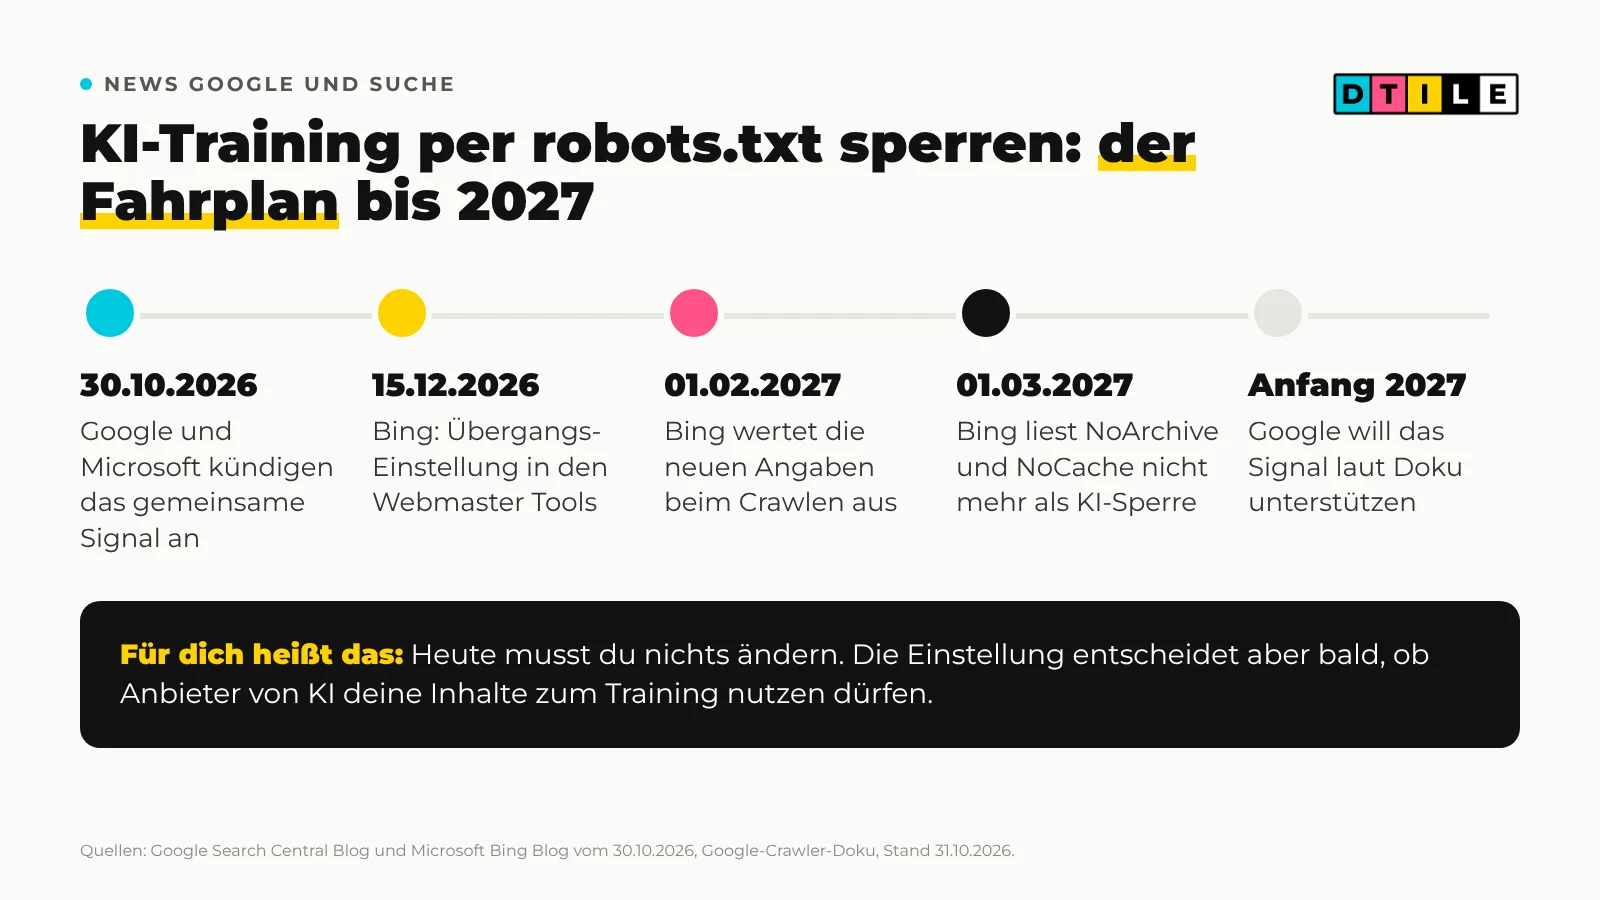
Handlungsbedarf mit festem Datum haben nur Websites, die heute NoArchive oder NoCache nutzen, um Microsoft die KI-Nutzung zu untersagen. Für alle anderen ändert sich bis Anfang 2027 nichts, solange sie nichts eintragen.
| Datum | Was passiert |
|---|---|
| 15. Dezember 2026 | Übergangs-Einstellung für KI-Antworten in den Bing Webmaster Tools, nur für Websites mit NoArchive oder NoCache |
| 1. Februar 2027 | Microsoft wertet die neuen Angaben beim Crawlen aus |
| 1. März 2027 | Frist: Danach liest Microsoft NoArchive und NoCache nicht mehr als Sperre für Training oder KI-Antworten |
| Anfang 2027 | Google will das gemeinsame Signal unterstützen |
| 30. September 2027 | Übergangs-Einstellungen in den Bing Webmaster Tools laufen spätestens aus |
15. Dezember 2026
- Was passiert
- Übergangs-Einstellung für KI-Antworten in den Bing Webmaster Tools, nur für Websites mit NoArchive oder NoCache
1. Februar 2027
- Was passiert
- Microsoft wertet die neuen Angaben beim Crawlen aus
1. März 2027
- Was passiert
- Frist: Danach liest Microsoft NoArchive und NoCache nicht mehr als Sperre für Training oder KI-Antworten
Anfang 2027
- Was passiert
- Google will das gemeinsame Signal unterstützen
30. September 2027
- Was passiert
- Übergangs-Einstellungen in den Bing Webmaster Tools laufen spätestens aus
Termine laut Microsoft Bing Blog und Google-Crawler-Dokumentation
Was lokale Unternehmen jetzt tun sollten
Für die meisten lokalen Betriebe ist Sichtbarkeit in KI-Antworten wertvoller als der Schutz vor Training. Wer in Gemini, Copilot oder ChatGPT als Empfehlung auftauchen will, sollte nicht pauschal sperren. 4 Schritte für die nächsten Wochen:
- robots.txt prüfen: Steht dort schon eine Sperre für Google-Extended, GPTBot oder andere KI-Crawler, und war die bewusst gewählt?
- Ziel festlegen: Sichtbarkeit in KI-Antworten oder Schutz eigener Texte, etwa bei kostenpflichtigen Inhalten oder eigenen Studien
- Gezielt statt pauschal sperren: Nur Bereiche wie einen Mitgliederbereich ausschließen, Leistungsseiten und Ratgeber offen lassen
- NoArchive und NoCache prüfen: Wer sie nutzt und Microsoft weiter ausschließen will, muss bis 1. März 2027 die neuen Angaben setzen
Wie du gezielt in KI-Antworten erscheinst, zeigt der Ratgeber KI-Sichtbarkeit. Ob deine robots.txt heute KI-Anbieter aussperrt und was dich das an Sichtbarkeit kostet, prüfen wir in der kostenlosen Potenzialanalyse in 15 Minuten.
Häufige Fragen zum robots.txt-Signal gegen KI-Training
Weiterlesen
Geschäftsführer DTILE GmbH · Local SEO & GEO Experte
Ich bin Engin Buldak, Geschäftsführer der DTILE GmbH in Hamburg. Seit über 20 Jahren arbeite ich an Sichtbarkeit bei Google und habe mit meinem Team mehr als 3.500 Unternehmen im DACH-Raum geholfen*, von lokalen Dienstleistern bis zu Filialbetrieben.
Als einer der First Mover für Generative Engine Optimization (GEO) baue ich KI-Sichtbarkeit nachhaltig auf der eigenen Website auf: Topical Authority, strukturierte Daten und Entitäten-Optimierung für Empfehlungen in ChatGPT, Perplexity und Google AI Overviews.
Wir glauben, dass gefunden werden sollte, wer die beste Arbeit macht. Nicht, wer das größte Werbebudget hat.